MySQL vs PostgreSQL 1부 (OLTP)
회사에서 신규 시스템의 DB선정 때문에 검색을 해봤지만
둘의 차이점은 검색을 해보면 정리가 잘되어있지만 개인적으로 수치로 직접 비교해보고싶어서 진행한 프로젝트이다.
환경 : OCI cpu4 24GB ubuntu
다음과 같이 검증해야할 통념들을 정리했다.
- 간단한 작업은 MySQL이 빠르다.
- 대규모 JOIN은 PostgreSQL이 더빠르다.
- 대규모분석은 PostgreSQL이 우위이다.
- 대규모데이터에서 PostgreSQL의 정합성,트랜잭션이 유리하다.
순수 성능 공정 비교를 위해 동일 리소스로 진행하였다.
- CPU 4 , 주버퍼 6GB, full fsync(둘다 안전모드)
- 병렬 워커 4 (DB에는 쿼리 하나에 몇 개의 워커(작업 프로세스/스레드)까지 붙일수 있냐를 정하는 설정값이있다.
(PostgreSQL 은 max_parallel_workers_per_gather , MySQL은 innodb_parallel_read_threads)
단, 두 설정의 적용범위는 전혀 다르다. (후술)
- 동일데이터 :같은 CSV를 양 엔진에 COPY/LOAD
- 동일인덱스(FK 패리티) -> MySQL은 FK제약을 걸면 인덱스 자동생성, PostgreSQL은 FK걸어도 참조하는 쪽 컬럼에 인덱스를 자동으로 안만들어 수동으로 설정
벤치 마크 도구
- sysbench : 표준DB벤치마크 도구
- EXPLAIN ANALYZE : DB에 내장된 명령어 (실행계획 + 각단계별 실제소요시간 확인)
- Python 하니스(harness) : 시나리오 스크립트(예:재고차감)
MySQL 과 PostgreSQL 의 메커니즘이 다르다.
병렬 워커 상한을 똑같이 4로 줘도 PostgreSQL은 그 4를 일반 조인 집계에 쓸수 있다 반면, MySQL의 단일 쿼리 내 병렬은 극히 제한적이어서 CHECK TABLE이나 조건없는 count(*) 풀스캔 같은 특수 작업에만 적용되고
JOIN, GROUP BY, 일반 SELECT는 스레드 하나가 전부 처리한다.
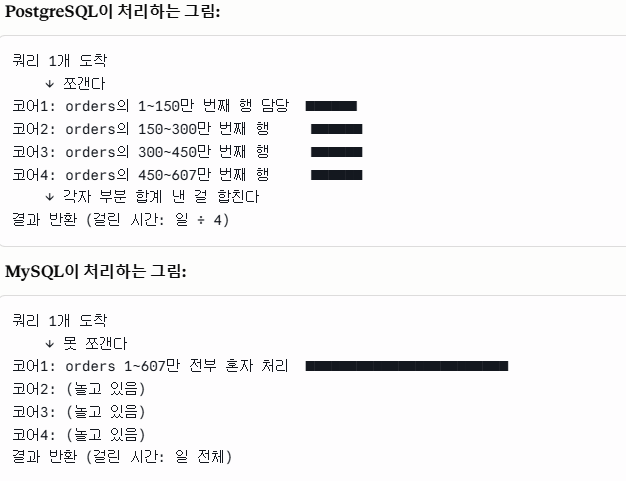
위와 같이 쪼갤수 없다 하지만
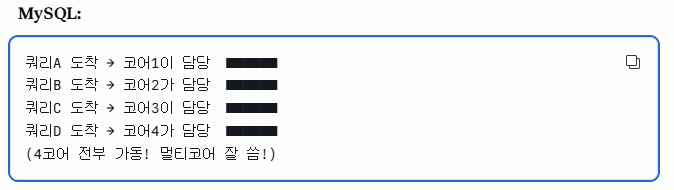
각각의 요청에 대한쿼리는 멀티코어를 쓴다.
1. 과연 간단한 작업은 MySQL이 빠를까?
다음은 MySQL 과 PostgreSQL 의 OLTP(OnLine Transaction Processing) 차이이다.
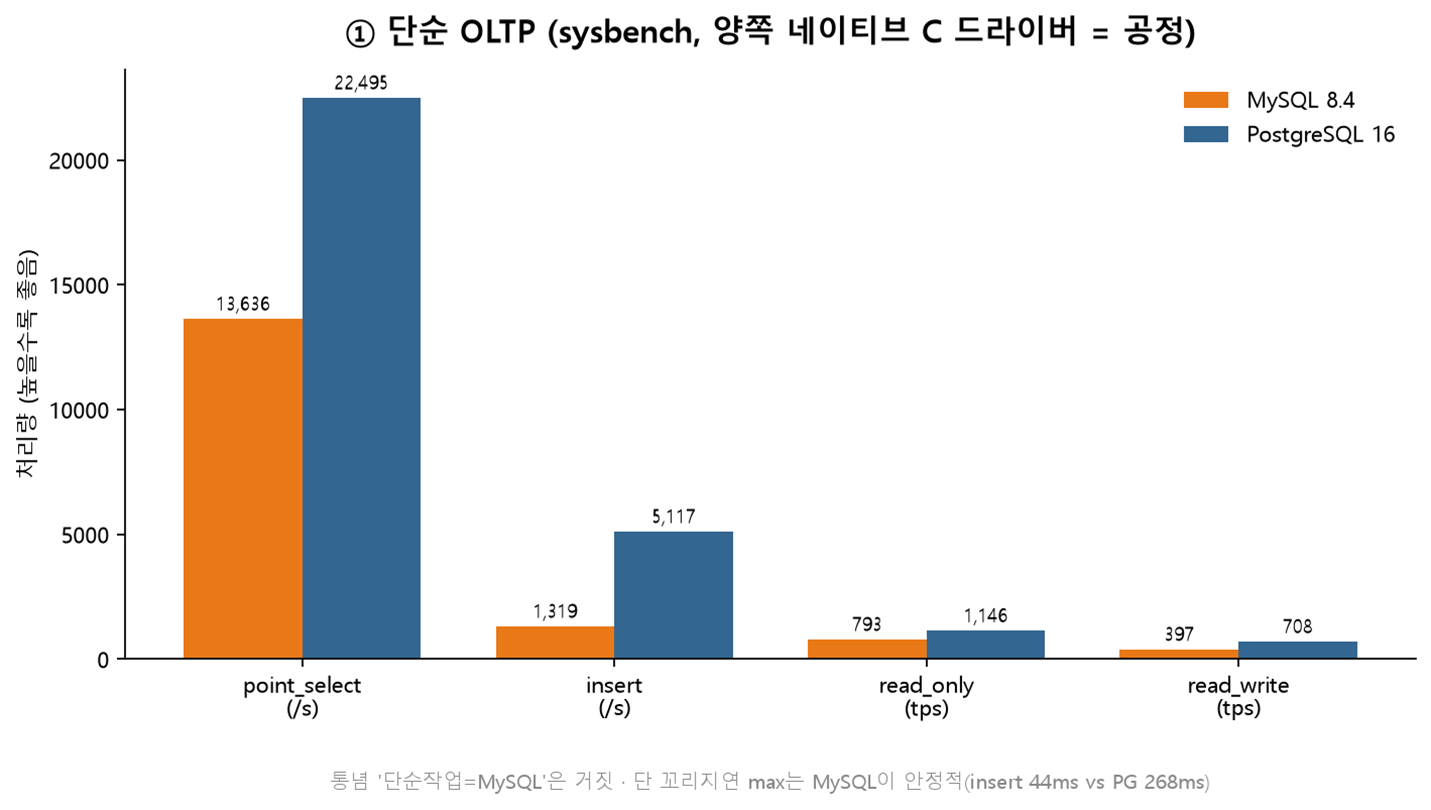
단순작업 처리량은 업계표준도구인 sysbench로 쟀다.
자체 테이블(sbtest, 10개 * 10만 행)을 만들었고
여기서 보는 건 순수하게 단순 경로를 얼마나 빨리 처리하느냐를 관점으로 진행하였다.
드라이버는 양쪽 다 네이티브 C(libpq/ libmysqlclient )로 맞추었다.
클라이언트 조건을 먼저 검증하고 시작하였다.
# 단건 PK 조회
sysbench oltp_point_select --tables=10 --table-size=100000 --threads=8 --time=30 run
# 단건 INSERT / 읽기 전용 / 읽기+쓰기 혼합
sysbench oltp_insert ... / oltp_read_only ... / oltp_read_write ... run
결과는 예상과 달리 PostgreSQL 의 우위였는데 point_select 1.65배, insert는 3.9배 가량 되었다.
확실하게 말할 수 있는 것은 "단순작업 = MySQL"이라는 근거가 현재 측정값에서는 볼수 없었다는것이다.
옛 MySQL 기본 엔진 MyISAM은 트랜잭션 조차 없는 가벼운 엔진이라 단순 조회가 정말 빨랐다.
현재 InnoDB는 트랜잭션,MVCC, 장애 복구를 갖추면서 그 가벼움을 잃었다.
PostgreSQL같은 경우 기본 설정이 매우 보수적이라 튜닝없는 벤치마크에서 불리했다고 한다. 하지만 이테스트는 양쪽 모두 6GB로 동등하게 설정해서 핸디캡도 없다.
insert 3.9배 경우 커밋 경로차이가 원인 (redo+binlog 이중 플러시 vs 단일 WAL) 일수 있는데
이 부분은 binlog 분리 실험으로 추후 검증할 예정이다.
그리고 최대지연(max latency)에서 상반된 결과 (insert 기준 MySQL 44ms vs PostgreSQL 268ms) 가 나오는데
PostgreSQL쪽 스파이크 유력한 원인으로 보자면 체크포인트와 오토배큠이다.
(출처 : PostgreSQL 공식문서 https://www.postgresql.org/docs/17/wal-configuration.html)
반면, MySQL은 더티 페이지를 백그라운드에서 완만하게 흘려보낸다.
확정 원인은 log_checkpoints 대조 실험으로 추후 검증할 예정이다.
(출처 : MySQL 공식문서 https://dev.mysql.com/doc/refman/8.4/en/innodb-parameters.html)
결국 처리량(초당 몇 건 처리)의 승자는 PostgreSQL 이지만 지연 안정성(최악의 순간 얼마나 나쁜가)의 승자는 MySQL라고 볼수있겠다.
PostgreSQL의 268ms가 자체적으로 치명적이기보다는 환경에 따라 달라진다.
예를들어 p99 지연(가장 느린 1% 요청의 응답시간)이 SLA로 묶인 대고객 API 또는 고트래픽 환경을 말한다.
PostgreSQL 에서는 checkpoint_completion_target 등으로 스파이크를 분산시키는 방법을 제시하고있어 튜닝으로 보완 가능성이 있어보인다. 추후 이부분을 테스트 검증해볼 예정이다.
다음 2부에서는 대규모 Join 비교를 다루면서 시작할예정이다.